
NDI 隔行源被当逐行源接入,怎样核对场类型与行高
隔行源要先辨认frame_format_type,以及当前缓冲代表整帧还是单个场,再决定行归属。只见到1080这个数字就当逐行图像处理,会把不同时间采样的场混在一起。场标识并不自动完成去隔行,也不证明显示端的刷新相位正确。
先固定输入与适用条件
附件用八行画面的抽象行号表示两场,约定顶行索引为零,field_0对应偶数行、field_1对应奇数行。这个约定用于核查代码分支;真实源需要同时核对SDK说明、发送实现和场序。不能从普通相机拍到的条纹反推是哪一场先到,也不要把视频码流帧高与单场缓冲高度混用。
本篇按NDI官方滚动SDK文档解释视频v2或音频v3帧描述。文档核对日期为2026-10-24;这不是本地已安装NDI运行库的版本声明,设备与第三方软件需另录版本。
按字段与边界执行
-
保存同一帧的yres、frame_format_type以及接收时是否允许字段化视频。保留原始枚举名称,避免日志把frame、field_0、field_1都简化成“隔行”。
-
先在完整八行模型上标出每场的原始行号,再为单场缓冲单独记录存储行数与对应的整幅行坐标。描述高度和实际行距必须一起核对。
-
使用附图检查两场交错后是否还原0至7的行序。若场被丢弃、重复或交换,应在结果表中显示缺失行,而不是让缩放器把半高画面悄悄撑满。
-
现场接入时分别留接收描述和显示处理选项,确认应用采用去隔行、场显示或其他策略。每种处理的时序和画质需要目标链单独验收。
用具体样例核对结果
合成模型将field_0列为0、2、4、6,field_1列为1、3、5、7,离线交错恢复后与原始八行完全相同。附件SVG直接标出每行所属场,result.json给出两场各四行与恢复顺序。这里只证明行号归属与重组函数一致,没有运行真实NDI解码器,也没有使用该模型去推断任何设备的扫描方式。
完整性判断要看八个原始行是否各出现一次;只有半数行或出现两个相同场时,应判为输入不完整。若图像静止时正确、运动边缘出现梳齿,还要核对不同场的时间位置与显示处理,这超出了行号模型。不要靠交换field名称反复试错后直接交付,原始枚举、接收选项与处理策略仍应留下可读记录。
下载与复现
analyze.py、field-lines.svg、input.json、result.json。
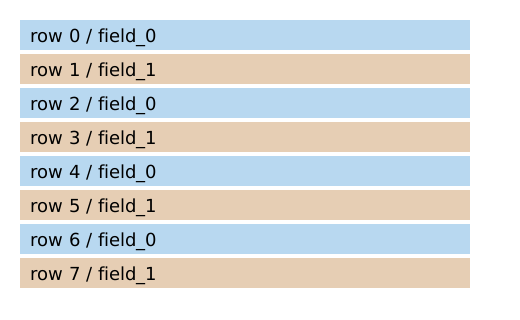
下载的场序SVG适合代码评审,输入和脚本可复算抽象行序。交接单上应把“整幅行坐标”和“单场缓冲行索引”分为两列,附上真实帧描述;未取得这些描述时,结果只能写待核对。
把输入与脚本保存到同一个本地目录后执行 python analyze.py,脚本只读取输入、计算并重写同目录的结果文件。先保留原始附件副本,再将自己的脱敏输入另存为新版本,记录输入摘要与执行日期;不要把合成字段覆盖成看似真实的现场日志。
已用 Python 3.12.4 实际运行附件算法并检查断言。结果来自同目录合成输入;没有接入真实NDI源、控制器、灯具、接收卡或LED屏,不能据此填写现场验收通过。
对接下一步与一级来源
基础背景可看NDI 网络视频传输协议详解。相关流程收在多媒体播放专题;需要项目对接时,带上本文输入及结果向SoftPlayer核对实际能力。
一级来源核对日期:2026-10-24。原始协议规则、本文原创运算和目标系统行为应分别留证;附件计算正确,不等于设备已经按该参数工作。
相关阅读
留言讨论
评论发布后会被人工复核,违规内容将被删除。
如果发表没有反应,可以前往联系我们告诉我们。